Door Tom Naberink
Er heerst een groot misverstand in onderwijsland: ‘ChatGPT traint op alle data die jij erin zet’.
Er heerst een groot misverstand in onderwijsland: ‘ChatGPT traint op alle data die jij erin zet’.
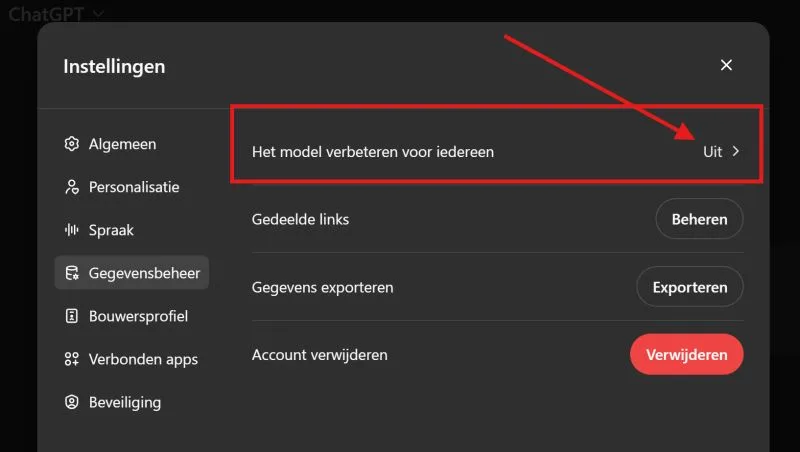
Ik heb dit de laatste tijd meerdere keren gehoord tijdens workshops/presentaties en ik verbaas ten zeerste over deze uitspraak. Je kunt dit namelijk heel simpel uitzetten bij de instellingen. Het enige wat je moet doen is binnen ChatGPT: 1) Ga naar instellingen 2) Ga naar het tabblad ‘Gegevensbeheer’ 3) Zet de optie ‘Het model verbeteren voor iedereen’ UIT
Nu zal OpenAI jouw data niet gebruiken voor het trainen van nieuwe modellen.
Let op, jouw data wordt nog steeds versleuteld opgeslagen in de VS. Net als al je gesprekken in WhatsApp overigens.
Op de een of andere manier leven we in een realiteit waarbij we in onderwijsland geen probleem hebben met dat we allerlei groepsapps op Whatsapp hebben met collega’s/studenten/leerlingen waarin we allerlei dingen delen (inclusief persoonsgegevens(!)). Maar als je ChatGPT op een verantwoorde manier gebruikt in het onderwijs, dus zonder persoonsgegevens of bedrijfsgeheimen te delen, worden mensen gek.
Dan ga ik het nog vreemder maken: Wisten jullie dat zowel SURF als Kennisnet in december een advies hebben uitgebracht dat je ook CoPilot niet moet gebruiken i.v.m. privacy issues?! Hoe willen ze dat we onze studenten voorbereiden op een werkveld waarin ze schreeuwen om AI-geletterde afstudeerders?
Mijn advies: Gebruik ChatGPT op een verantwoorde manier en leer je studenten het te gebruiken op een verantwoorde manier.
p.s. kleine reclameboodschap: Op vrijdag 18 april geef ik nog een workshop over AI in het onderwijs en er zijn nog wat plekken beschikbaar. In 1 dag leer je prompten, gepersonaliseerde chatbots bouwen en hoe je AI verantwoord kan inzetten om je werk sneller en beter te kunnen doen als docent. Meer info op AI-workshops voor onderwijsorganisaties