Door Marcel Mutsaarts
AI scoort minder dan 1% waar tieners 100% halen. Echt waar?
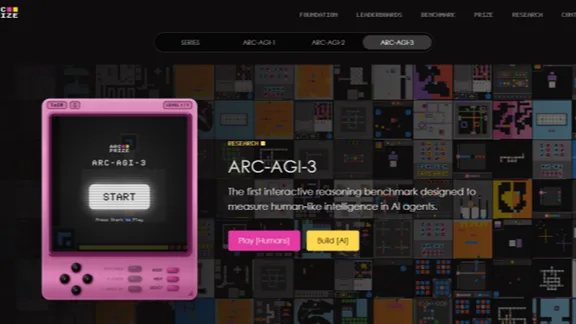
Ik zat net in de auto naar AI Report te luisteren. Wietse Hage besprak de nieuwe ARC-AGI-3 benchmark met de cijfers die inmiddels overal rondgaan: de beste AI-modellen scoren minder dan 1%, terwijl gewone mensen alles oplossen. Zelfs een doorgaans scherpe en goed geïnformeerde AI-journalist als Wietse leek de framing zonder veel vragen over te nemen. En dat triggerde me, want beide claims verdienen stevige nuancering.
Even voor de context. ARC-AGI-3 is een interactieve benchmark waarin AI-agents in onbekende game-omgevingen worden gedropt. Ze moeten zelf de regels ontdekken, doelen afleiden en strategieën bedenken. Geen instructies, geen hints. Het uitgangspunt van bedenker François Chollet, dat echte intelligentie draait om aanpassingsvermogen op onbekende taken, is wetenschappelijk verdedigbaar en stelt een relevante vraag. Kunnen de huidige AI-modellen zich aanpassen aan volledig nieuwe situaties waar ze niet op getraind zijn?
Alleen wordt het antwoord op die vraag verpakt in een framing die meer op PR lijkt dan op wetenschap.
Wat betekent die "minder dan 1%" eigenlijk?
Wanneer je leest dat AI minder dan 1% scoort, denk je al snel dat de modellen minder dan 1% van de opgaven goed oplossen. Dat is het niet. De score meet hoe efficiënt een AI een omgeving oplost vergeleken met de beste menselijke prestatie. En die vergelijking wordt kwadratisch bestraft. Concreet: als een mens een level in 10 acties oplost en een AI in 100 acties, dan is de score (10/100)² = 1%. De AI lost het level dus wél op, alleen met tien keer zoveel stappen. Lineair gemeten zou dat 10% zijn. Door de kwadratische formule wordt het 1%.
Daar bovenop worden latere levels zwaarder gewogen in de eindscore. Elke omgeving heeft meerdere levels die in moeilijkheid oplopen, en level 5 telt vijf keer zo zwaar mee als level 1. Dat is logisch vanuit het idee dat je wilt meten of een AI geleerde regels kan combineren. Maar het is juist op die compositionele levels waar AI het hardst faalt. En precies daar geldt ook nog een harde afkapgrens: als een AI meer dan vijf keer zoveel acties nodig heeft als een mens, wordt de poging afgebroken. Dit bestaat puur om kosten te beheersen (een volledige testronde kost tienduizenden dollars), maar het betekent wel dat een AI-systeem geen kans krijgt om via langere exploratie alsnog tot een oplossing te komen. De combinatie van zware weging en vroegtijdig afbreken maximaliseert de score-kloof precies waar het ertoe doet.
Daarnaast is er de "no harness"-regel: AI-agents mogen geen enkele vorm van externe tooling gebruiken. Geen vooraf gebouwde waarnemingspipeline, geen scaffolding, niets. Hier is een belangrijk onderscheid nodig. Een taakspecifiek harnas, gebouwd om precies deze benchmark te kraken, zou je inderdaad willen uitsluiten. Dat test immers de menselijke creativiteit van de bouwer en niet de intelligentie van het model. Maar een algemeen harnas, zoals een visuele waarnemingslaag of een standaard planningsmodule, hoort gewoon bij hoe een modern AI-systeem functioneert. Dat verbieden is zoiets als een mens vragen om een spelletje te spelen met een blinddoek om, en vervolgens concluderen dat mensen slecht zijn in games. Het model wordt kunstmatig verzwakt op een manier die weinig zegt over de eigenlijke redeneercapaciteiten.
Elke individuele ontwerpkeuze is op zichzelf verdedigbaar. Kwadratische scoring? Staat in de robotica-literatuur. Bovenmenselijke baseline? Stelt een ambitieus doel. Gewogen levels? Meet compositionaliteit. Geen tooling? Test autonomie. Maar de stapeling van al deze keuzes is zorgvuldig gecalibreerd om spectaculair lage scores te produceren. Geweldig voor krantenkoppen, minder informatief als wetenschappelijke meting.
En die 100% voor gewone mensen dan?
Ook dat verdient context. De 100% slaat op voltooiing: ja, alle 135 omgevingen werden door mensen opgelost. Maar de AI-modellen worden beoordeeld op een heel andere metriek, namelijk de RHAE-efficiëntiescore. Op diezelfde metriek zou een gemiddeld mens waarschijnlijk ergens rond de 20 tot 30% uitkomen, omdat de baseline de op-één-na-beste menselijke prestatie is. "Mensen 100%, AI minder dan 1%" vergelijkt dus twee totaal verschillende dingen. Het klinkt als een afgrond, maar de werkelijke kloof is een stuk genuanceerder.
Het perceptieprobleem
Er speelt nog iets opmerkelijks. Mensen krijgen de games visueel te zien op een scherm, zoals je een computerspelletje speelt. AI-agents krijgen ruwe JSON-data: rijen en kolommen met cijfers. Toen onderzoekers van Duke University Claude Opus visuele input gaven in plaats van JSON, sprong de score van 0% naar 97%.
Chollet's verweer is principieel: echte AGI moet zelf kunnen bedenken om die data te visualiseren. Daar zit wat in. Tegelijkertijd maakt het de scores lastig te interpreteren. Faalt een AI op het redeneren, of simpelweg op het ontbreken van basale waarneming? Je test eigenlijk twee dingen tegelijk, zonder dat je kunt ontrafelen welk van de twee het probleem is.
De eerlijke samenvatting
Of er een grote kloof is tussen wat AI-systemen en mensen kunnen in onbekende situaties, weten we op basis van deze benchmark eerlijk gezegd niet. De scores worden vertekend door kwadratische bestraffing, een bovenmenselijke baseline, het ontbreken van visuele waarneming en een harde afkapgrens op de zwaarst wegende levels. Dat maakt "minder dan 1% versus 100%" een karikatuur van een meting die we niet zuiver kunnen interpreteren.
ARC-AGI-3 stelt de juiste vraag. De manier waarop de antwoorden worden gepresenteerd zegt alleen minstens zoveel over onze honger naar sensatie als over de werkelijke staat van AI.
Hopelijk lees je door mijn artikel nu dit soort koppen met meer nuance en een gezonde kritische houding. Overigens geldt dat ook bij koppen waaruit zou blijken dat AI alles kan, dat het nieuwste model nog beter is enz. Mijn simpelste advies is eigenlijk om de modellen gewoon zelf te proberen en je eigen oordeel te vormen.
Wil je meer weten over de verantwoorde integratie van AI in het onderwijs, kijk dan op https://aivoordocenten.nl/, het platform van Barend Last, Tom Naberink en ikzelf.